Cuando utilizamos un ordenador de la manera tradicional, alguien tiene que decirle exactamente qué debe hacer. Un programador escribe las instrucciones y establece las reglas: «Si ocurre A, haz B; si ocurre C, haz D».
El Machine Learning, o aprendizaje automático, funciona de una manera diferente. En lugar de programar todas las reglas una por una, proporcionamos al ordenador muchos ejemplos y dejamos que encuentre por sí mismo los patrones que hay en esos datos.
Por ejemplo, imaginemos que queremos que un ordenador sea capaz de distinguir entre perros y gatos. Una posibilidad sería intentar escribir miles de reglas: «si tiene las orejas de esta forma, si tiene el hocico de esta longitud, si pesa aproximadamente esto…». Sería una tarea prácticamente imposible.
Con Machine Learning podemos hacer algo diferente: mostrarle miles o millones de fotografías de perros y gatos y decirle cuál es cuál. El sistema analiza esos ejemplos y va aprendiendo qué características suelen aparecer en cada caso. Después podremos mostrarle una fotografía que nunca haya visto y pedirle que haga una predicción.
Existen diferentes formas de aprendizaje automático. Dos de las más importantes son el aprendizaje supervisado y el aprendizaje no supervisado.
En el aprendizaje supervisado, los datos que utilizamos para enseñar al sistema están etiquetados. Es decir, conocemos de antemano cuál es la respuesta correcta.
Imaginemos, por ejemplo, que queremos construir un sistema capaz de estimar la temperatura de una estrella. Podemos proporcionarle información sobre miles de estrellas junto con su temperatura, que ya conocemos. El sistema intentará encontrar la relación entre esas propiedades y la temperatura. Una vez aprendido ese patrón, podremos darle los datos de una estrella nueva y pedirle que estime su temperatura.
En el aprendizaje no supervisado, en cambio, no proporcionamos esas respuestas correctas. Le damos al ordenador un conjunto de datos y le pedimos que encuentre por sí mismo estructuras o grupos dentro de ellos.
Por ejemplo, podemos tener información sobre miles de estrellas y pedirle que encuentre grupos de estrellas que tengan propiedades similares, sin decirle previamente cuáles son esos grupos.
Una de las técnicas de Machine Learning que más ha evolucionado en los últimos años son las redes neuronales artificiales. Están inspiradas, de una manera muy simplificada, en el funcionamiento de las neuronas de nuestro cerebro.
Una red neuronal está formada por muchas unidades conectadas entre sí. Cada conexión tiene asociado un número llamado peso. Estos pesos determinan cuánto influye la información que pasa de una unidad a otra.
Al principio, el sistema no sabe cuáles son los valores adecuados para esos pesos. Por eso hay que entrenarlo.
Imaginemos que queremos enseñar a una red neuronal a reconocer algo. Le damos un ejemplo y la red hace una predicción. Después comparamos esa predicción con la respuesta correcta.
Si se ha equivocado, calculamos cuánto se ha alejado de la respuesta correcta y modificamos ligeramente los pesos de la red para intentar reducir ese error.
Después le damos otro ejemplo y volvemos a repetir el proceso.
Y otro.
Y otro.
Y otro.
Después de repetir este proceso miles, millones o incluso miles de millones de veces, la red neuronal ha ido ajustando sus parámetros hasta encontrar una combinación que le permite realizar cada vez mejores predicciones.
Esto es, en esencia, entrenar una red neuronal: modificar sus parámetros a partir de muchos ejemplos para conseguir que cometa cada vez menos errores.
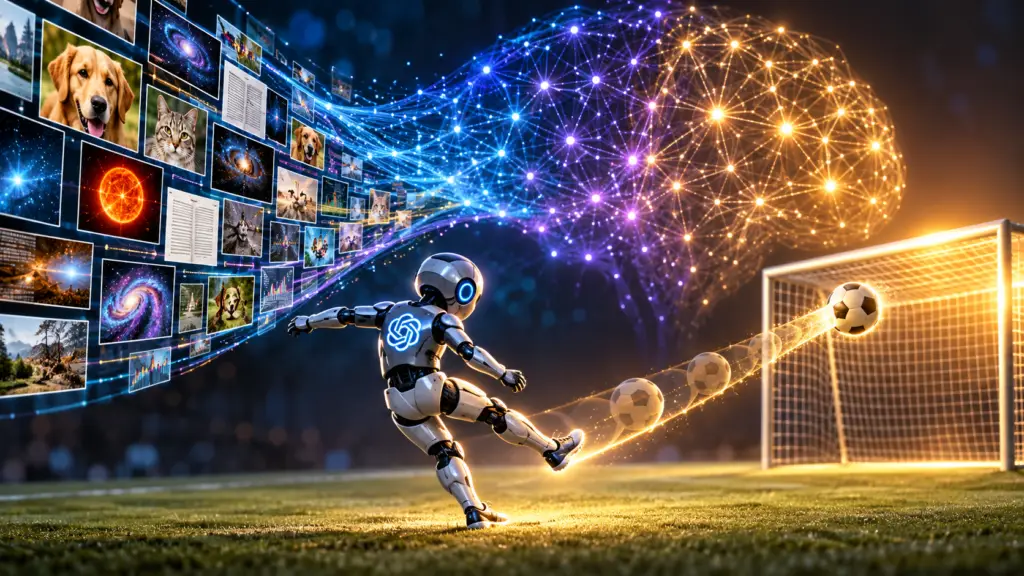
Una forma sencilla de entenderlo es imaginar que queremos enseñar a una máquina a tirar penaltis.
La máquina realiza un primer lanzamiento. Probablemente falla.
Entonces cambia ligeramente la fuerza con la que golpea el balón y modifica el ángulo.
Vuelve a lanzar.
Si el resultado mejora, mantiene parte de esos cambios. Si empeora, realiza otros ajustes.
Y vuelve a intentarlo.
Después de repetir el proceso una enorme cantidad de veces, la máquina habrá encontrado matemáticamente qué combinaciones de fuerza y dirección producen mejores resultados.
Eso es, de una manera muy simplificada, lo que hace una red neuronal durante su entrenamiento: prueba, mide el error y ajusta sus parámetros para intentar reducirlo.
Por supuesto, una red neuronal no «piensa» como una persona ni entiende necesariamente lo que está haciendo. Lo que hace es realizar cálculos matemáticos sobre enormes cantidades de datos y ajustar sus parámetros para encontrar patrones que le permitan obtener mejores resultados.
Cuando hoy hablamos de inteligencia artificial solemos pensar en sistemas como ChatGPT, capaces de mantener conversaciones, escribir textos, generar imágenes o responder preguntas.
Estos sistemas utilizan redes neuronales de enorme tamaño y han sido entrenados con cantidades gigantescas de información.
Una de las familias de modelos más conocidas son los LLM (Large Language Models), es decir, modelos de lenguaje de gran tamaño. Su objetivo es aprender los patrones del lenguaje para poder generar y comprender texto.
Durante su entrenamiento, estos modelos procesan cantidades enormes de información y ajustan sus parámetros para mejorar sus predicciones. Por ejemplo, de una manera simplificada, pueden aprender a predecir qué palabra o fragmento de texto tiene más probabilidades de aparecer a continuación dadas las palabras anteriores.
Los modelos actuales pueden tener miles de millones de parámetros. Para hacernos una idea de la magnitud, GPT-3, presentado por OpenAI en 2020, tenía alrededor de 175.000 millones de parámetros.
Un parámetro es, simplificando mucho, un número que el modelo puede ajustar durante el entrenamiento. Los parámetros son los que permiten al modelo aprender y representar los patrones que encuentra en los datos.
Entrenar un modelo de estas dimensiones requiere una enorme capacidad de cálculo. Para ello se utilizan grandes cantidades de procesadores especializados, como las GPU, y se necesita una cantidad considerable de energía.
Por eso, cuando hablamos de inteligencia artificial, no estamos hablando simplemente de un programa informático que alguien ha escrito con millones de reglas. En los modelos modernos, buena parte de su comportamiento surge de un proceso de aprendizaje a partir de enormes cantidades de datos, durante el cual el sistema ajusta millones o miles de millones de parámetros para encontrar patrones y reducir sus errores.
En pocas palabras, programar tradicionalmente es decirle a la máquina qué reglas debe seguir; entrenar una IA es darle ejemplos y permitir que encuentre los patrones que necesita para realizar una determinada tarea.